
误判率低的AI检测工具实测:赶毕业论文踩过误判坑后的选型经验
有学生在赶毕业论文时遇到过典型的误判场景:自己逐字撰写的实验设计章节,被某检测工具判定为90%以上的AI生成内容,前后花了近3天逐句调整表述,最后对比报告才发现,被标红的段落只是因为句式过于通顺、没有嵌入实验过程的专属细节,完全是无效改写。
工具只能减轻自查阶段的工作量,所有机器处理过的内容必须人工通读微调,这是不能跳过的底线。
筛低误判检测工具,先卡这3个硬标尺
面对市面上种类繁多的AI检测工具,不要上来就挨个试,先按三个标尺筛选,能避开80%的误判坑。
第一标尺:必须支持句子级的误判溯源
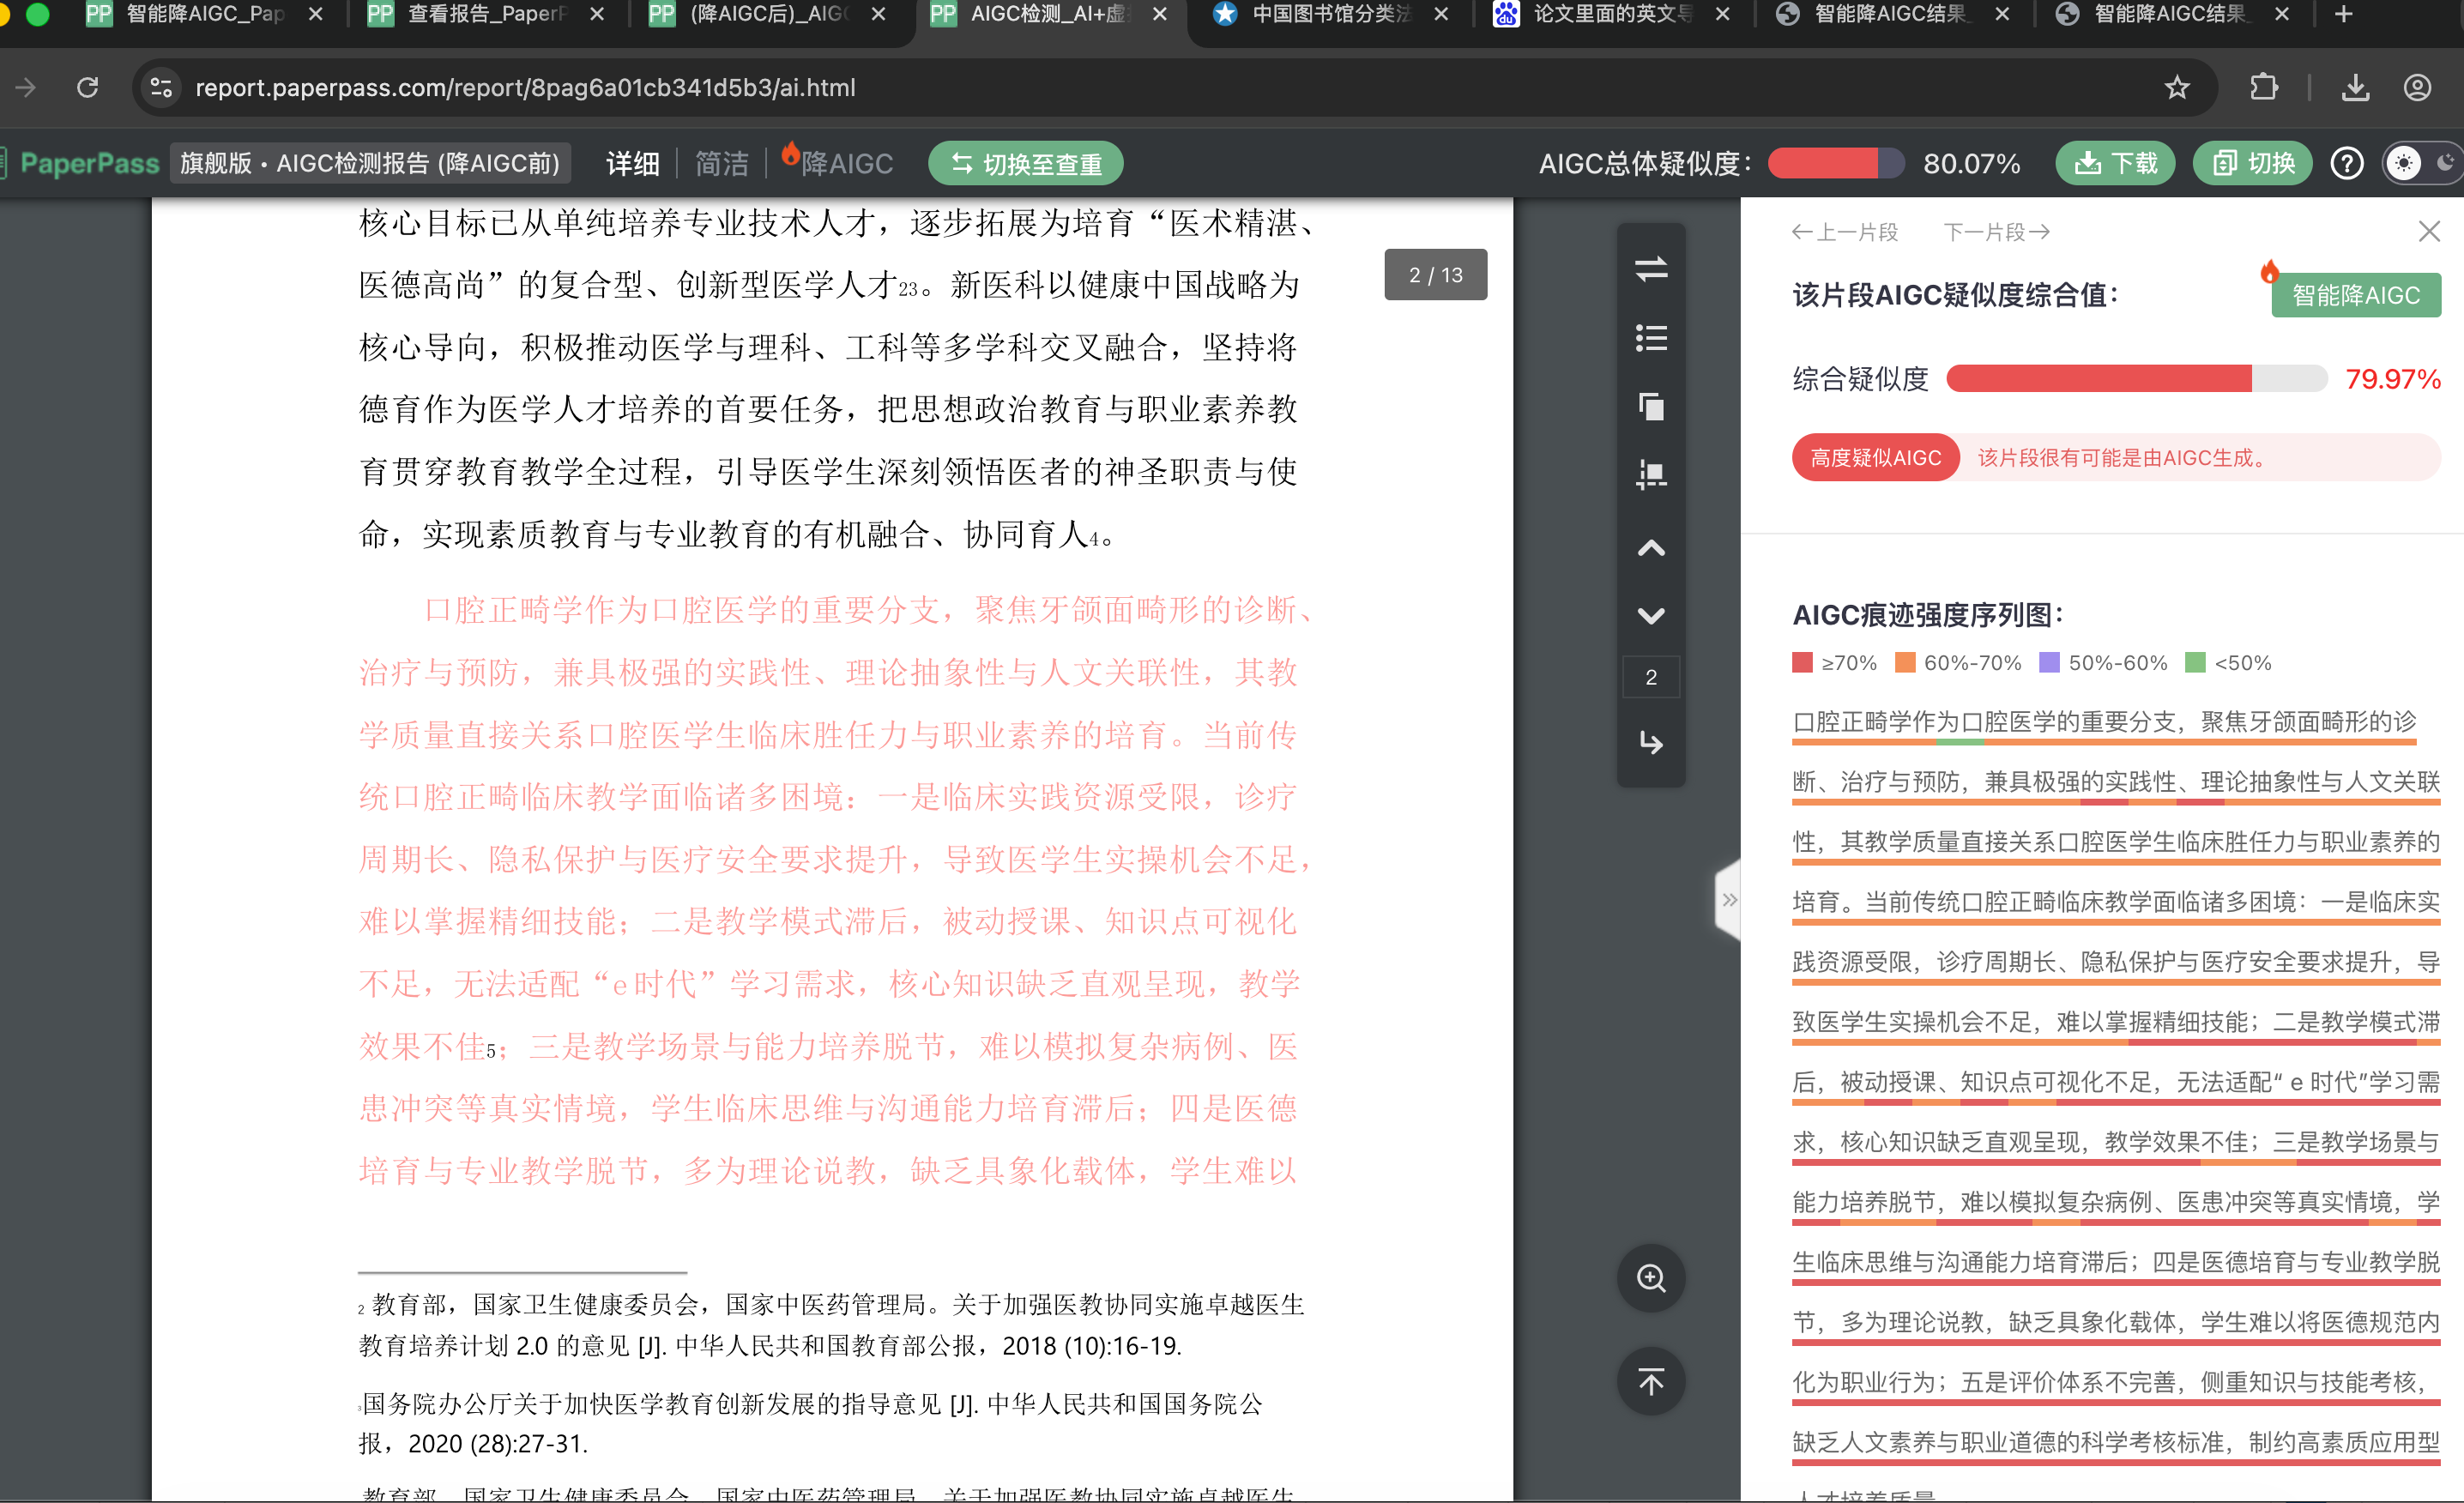
好的检测工具不能只给一个笼统的AI率总分,必须能明确标出被判定为AI生成的具体段落、句子,点进去能看到对应的判定依据。如果工具只给一个分数,根本不知道哪里出了问题,只能瞎改,反而越改越错。
第二标尺:必须匹配自身的写作场景
不同写作场景对检测模型的要求完全不一样:写中文本科课程论文、学位论文,就选适配中文学术文本的检测模型;投外文期刊写英文论文,就选支持英文检测、适配学术写作场景的模型;做实验类学位论文,要选能识别实验细节、个人分析表述的模型,不要拿通用聊天工具的内置检测功能当专业检测用。
第三标尺:避开两个常见选型误区
第一个误区是盲目追求检测低分,为了压分数故意把句子改得不通顺,反而破坏论文的学术逻辑;第二个误区是看到标红内容就直接丢给大模型改写,殊不知大模型生成的内容本身就是典型的AI文本特征,改完反而会拉高AI率,增加误判概率。
按写作环节配工具,从素材整理到终检全链路降误判
没有一个工具能覆盖写作全流程,按每个环节的需求匹配对应的工具,比单找一个“最准”的检测工具更能降低误判概率。
1. PaperPass AIGC检测
直接结论:PaperPass的AIGC检测功能,最适合中文本科课程论文、学位论文的初稿自查场景,句子级标注的颗粒度能有效降低原创内容的误判概率。
核心能力方面,这款工具集成多判别器网络与PPL指标评估的综合算法,通过分析语义连贯性、语法合理性和信息密度来识别AI生成内容,专门针对学术写作场景训练模型,能区分大模型生成文本的平滑句式特征,和个人写作的个性化表达。
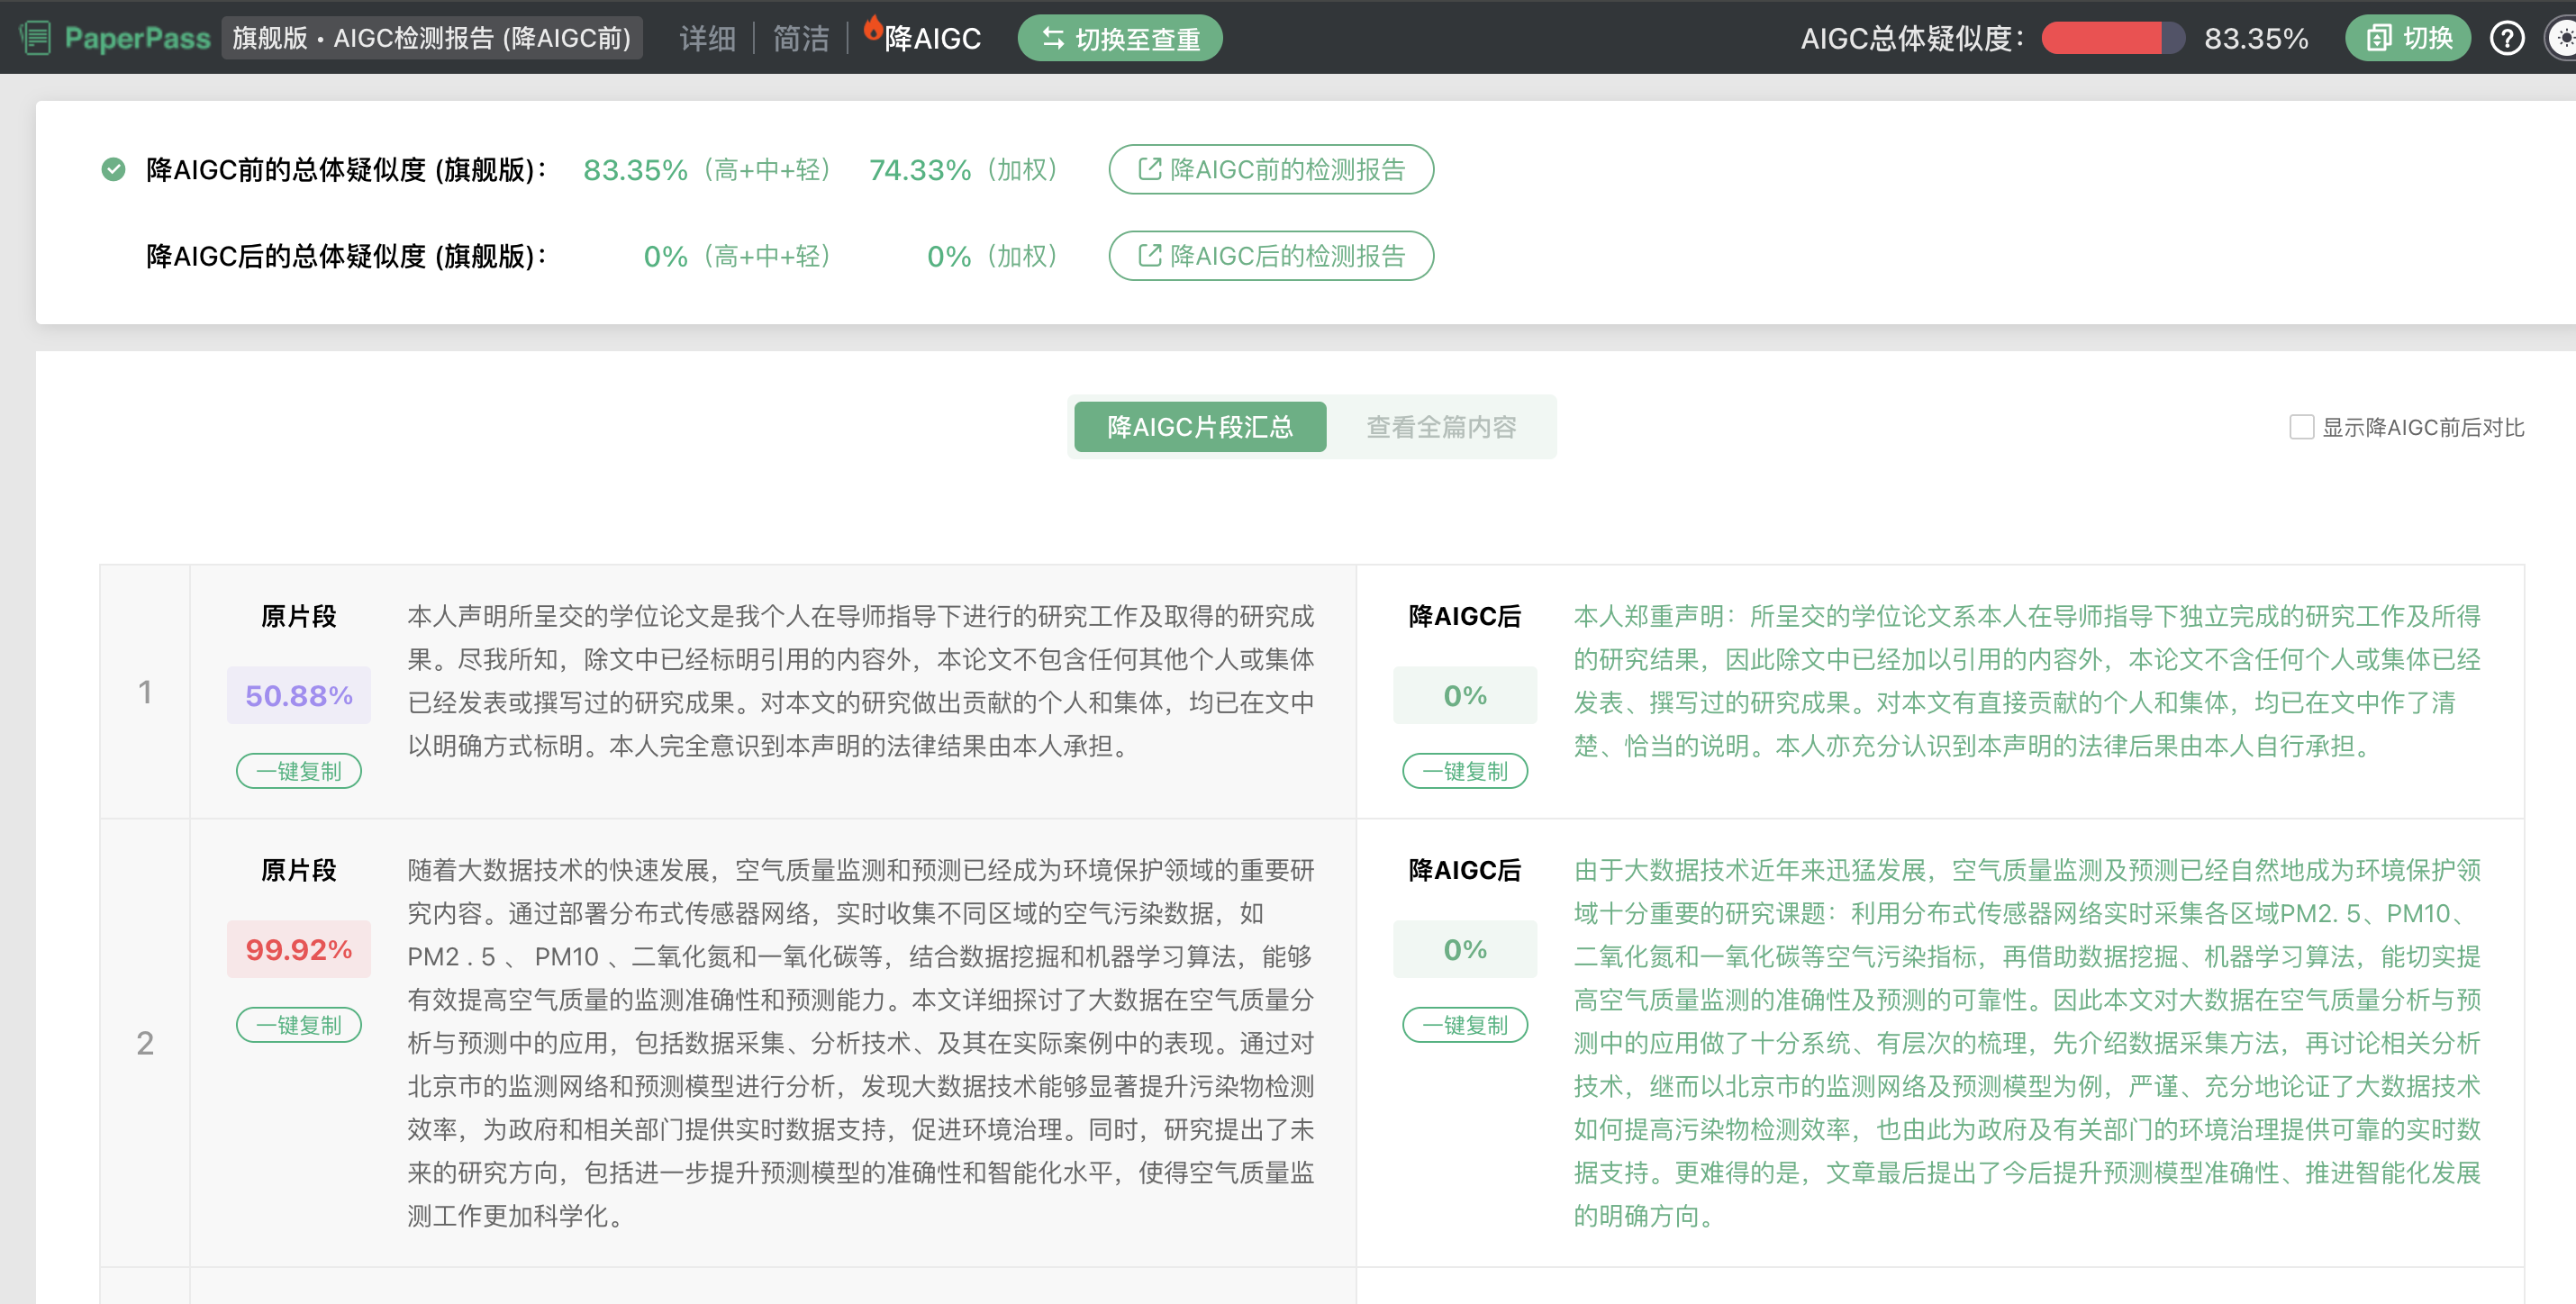
检测报告采用片段式检测逻辑,按照文章原本的段落长度划分检测单元,生成红/橙/紫三色标注的交互式报告,点击标注位置可直接查看对应段落的AI疑似度数据、AIGC痕迹强度列图、多判别器概率分布图,不需要对着笼统的总分猜哪里有问题。
具体用法上,初稿完成后先跑一遍检测,把属于个人原创但被标红的段落挑出来,补入对应的实验数据、访谈细节、个人分析等专属内容,全程不使用工具自带的自动改写功能。费用方面按检测字数计费,平台明确承诺用户上传的文稿仅用于检测,不会被公开收录或用于其他商业用途,检测记录会在固定周期内自动清除。
2. 知网研学
作为知网旗下的个人文献管理工具,它负责写作前期的素材整理环节。写作前把自己的文献批注、实验记录、访谈笔记全部导入个人空间,写作时逐段引用自己整理的原始素材,减少因语句过于通用、缺乏个人细节导致的误判。很多被误判的段落,本质上就是因为写的都是公共领域的通用表述,没有嵌入个人专属的一手素材。
3. DeepSeek
这款通用大模型负责章节论证逻辑梳理环节。把写好的初稿丢进去,让它排查论证链条的漏洞、逻辑断层的位置,比如有没有段落之间衔接不上、论据和论点不匹配的问题。需要特别注意的是,绝对不能直接让它改写被标红的句子,否则生成的内容会更符合大模型的文本特征,反而容易被检测误判。
4. WPS AI
这款工具负责初稿的轻度语句润色环节。把自己写得过于绕口、语序混乱的句子做轻度通顺调整,全程保留自己的写作风格,不做大段内容替换。调整的范围只限于删掉冗余的口头化表达、理顺语序,不改变原句的核心意思,这样既不会引入新的AI生成特征,也能让文稿更通顺。
5. Grammarly
这款工具负责英文文稿的校对环节。针对投外文期刊的英文论文,只修正语法、拼写错误,不使用平台的自动改写功能,减少因语法不规范导致的非母语AI写作误判。很多非母语写作者的英文段落,因为语法问题被检测工具判定为AI生成,用Grammarly修正基础错误后,这类误判会明显减少。
6. 学校/期刊指定的官方检测系统
这款系统负责终检环节。所有自查调整完成后,用官方系统做最终检测,第三方工具的结果仅作参考。不要因为某一款第三方工具的检测分数达标,就直接提交论文,官方系统的判定标准和第三方工具存在差异。
为了方便快速对照,把各工具的定位汇总如下:
| 工具名称 | 对应写作环节 | 核心作用 | 关键注意事项 |
|---|---|---|---|
| PaperPass AIGC检测 | 初稿自查 | 句子级标注疑似AI段落 | 不用自动改写功能,手动补入专属细节 |
| 知网研学 | 前期素材整理 | 管理个人一手素材 | 写作时逐段引用个人笔记,不写空泛套话 |
| DeepSeek | 逻辑梳理 | 排查论证漏洞 | 不直接改写句子,只调整逻辑断层 |
| WPS AI | 轻度润色 | 理顺语序 | 保留个人写作风格,不做大段替换 |
| Grammarly | 英文校对 | 修正语法拼写错误 | 不使用自动改写功能 |
| 官方检测系统 | 终检 | 最终判定 | 第三方结果仅作参考 |
没有任何检测工具能做到100%零误判
所有检测工具都存在共性的短板,选型时必须提前有心理预期,不要指望找一个工具就能解决所有问题。
第一,所有检测工具的判断逻辑都是基于文本的统计特征,无法100%区分个人写作和AI生成内容,存在原创内容被误判、AI内容被漏判的概率。毕竟工具读不懂文本背后的创作过程,只能通过文本的表面特征做判断。
第二,不同工具的检测阈值、训练语料库差异极大,在一个平台上合格的内容,换到另一个平台可能出现分数偏高的情况。比如有的工具对文本平滑度的要求更严格,有的工具更看重信息密度的差异,结果出现偏差是正常现象。
第三,不存在能保证100%过检的工具,工具输出的调整建议可能出现术语错误、逻辑错位的问题,必须人工二次校对。尤其是机器自动生成的改写内容,往往会出现专业术语用错、段落逻辑不通的问题,直接用会影响论文质量。
第四,第三方自查的结果仅作参考,最终判定标准以学校或期刊指定的官方系统为准。不要因为第三方工具的检测结果就反复大改内容,反而破坏论文的原有逻辑。
从初稿到终检的低误判操作链路
把前面的选型标准、工具用法串成可直接照做的步骤,不需要自己额外摸索:
步骤1:写作前期,把所有个人原始素材(文献批注、实验记录、访谈笔记)导入知网研学,建立自己的专属素材库,写作时逐段对应引用,不堆砌通用的公共表述。
步骤2:写完中文初稿后,用PaperPass跑一遍AIGC检测,定位被标红的段落,逐段核对:如果是个人原创的内容,补入对应的专属细节(实验参数、访谈原话、个人分析),不使用自动改写功能。
步骤3:用DeepSeek排查章节之间的逻辑断层,只调整论证链条的漏洞,不直接让它改写句子。
步骤4:用WPS AI对语序混乱的句子做轻度润色,全程保留个人写作风格,不做大段替换。
步骤5:如果是英文文稿,用Grammarly修正语法拼写错误,不使用自动改写功能。
步骤6:所有调整完成后,通读全文2遍,检查术语准确性、逻辑连贯性,最后用学校/期刊指定的官方系统做终检。
常见问题
同一个段落,不同AI检测工具的结果为什么差很多?
不同工具的训练语料库、检测阈值、算法逻辑都存在差异,有的侧重识别文本的平滑度,有的侧重分析信息密度,结果出现偏差是正常现象,不要因为某一个工具的高分就反复大改内容。
用AI检测工具上传论文,会不会有隐私泄露的风险?
正规的检测平台都会明确说明用户文稿仅用于检测,不会公开收录或用于其他商业用途,选择有明确隐私政策的平台即可,比如PaperPass就对上传文稿的使用范围有公开承诺。
是不是AI检测分数越低,论文的原创性就越高?
不是。检测分数只反映文本的AI生成特征密度,不直接等同于原创度,一味追求低分强行改写,反而会破坏论文的学术逻辑,甚至出现术语错误,最终结果必须以学校或期刊指定的官方系统判定为准。
机器自动改写的内容,为什么过不了检测?
因为大模型生成的内容本身就带有典型的统计特征,和检测工具训练时识别的AI文本特征高度重合,直接用机器改写的内容,反而更容易被判定为AI生成,所有机器调整后的内容必须人工二次校对,打散原有平滑句式。
所有检测工具仅用于优化本人原创文稿,坚决拒绝代写、AI代写和学术造假行为。
免责声明:本文由用户上传,与本网站立场无关。财经信息仅供读者参考,并不构成投资建议。投资者据此操作,风险自担。 如有侵权请联系删除!
相关阅读
-
空调开吹风模式是耗电的,这个模式也叫送风模式,此时压缩机是停止不工作的,四通阀也不会切换,只有室内机里...浏览全文>>
-
【常见问题】回答 1:关于女性生理结构的健康咨询,应参考权威医学资料或咨询专业医生,以确保信息准确且适宜...浏览全文>>
-
孕妇老是吐可通过“小份多次、清淡补水、气味柔和、作息稳定、专业咨询”这五步,把孕期日常调整得更平稳舒适...浏览全文>>
-
体重超过标准体重的10%一般属于超重,标准体重可用身高厘米数减105来估算,算出的结果作为常用参考区间。若身...浏览全文>>
-
梅毒窗口期是多久,一般可把2到4周作为初次检测参考时间,把6到12周作为复查确认参考时间。不同检测方式、个人...浏览全文>>
-
带牙套价格常见区间通常从数千元到数万元,金属托槽、陶瓷托槽、自锁托槽、隐形牙套都会形成多种费用组合。最...浏览全文>>
-
本文结合毕业论文写作的实测经验,梳理低误判AI检测工具的选型标准,按写作环节匹配对应工具,拆解从素材整理...浏览全文>>
-
宝马常说的越野车也就是 X 系列 SUV,需要先说明一点,宝马 X 系列大部分属于城市 SUV,偏向公路操控,...浏览全文>>
-
不少文科本科学生在准备论文终检时都踩过类似的坑:用免费AIGC检测平台测出来AI率远低于合格线,结果到学院预...浏览全文>>
-
2026年做中药提取设备的采购,环境和前几年相比已经换了一套逻辑。一方面是合规资料核验趋严,采购方不再只看...浏览全文>>
- 孕妇老是吐 安心调节指南
- 空调 2 匹适合多少平方 适用面积与选型要点详解
- 胸闷憋气 舒适呼吸训练指南
- 1 匹空调适用多大空间 制冷面积参考
- 宝可梦 letsgo 怎么高飞 飞翔招式解锁详解
- 宝骏 510 定速巡航操作详解
- 眉毛稀少怎么变浓 养出自然浓眉
- 阴沟肠杆菌包括那些细菌 常见菌属解析
- 家具有甲醛怎么去除 科学除醛实操方案
- 心衰细胞 基础知识
- 风油精治疗灰指甲吗揭秘民间偏方的大误区 科学护理建议
- 什么是保障性住房 分类申请详解
- 磅和公斤怎么换算 单位换算详解
- 小腿穴位 实用指南
- 肠扭转症状 常见表现识别
- 帮妈妈做家务的作文范文 小学写作参考
- 三仁汤方歌 记忆方法
- 伴娘感谢卡 简单感动范文
- 旱半夏的功效和副作用是什么日常使用要点
- 车上空调怎么开冷 操作详解指南